Kurzy živého výuku Velkých dat (Big Data), vedené lektorem online nebo na místě, začínají úvodem do základních konceptů Velkých dat a postupně přecházejí k programovacím jazykům a metodologiím používaným pro analýzu dat. Probírá se, porovnává se a v demonstračních praktických relacích se implementuje nástrojové vybavení a infrastruktura pro uskladňování Velkých dat, distribuované zpracování a škálovatelnost.
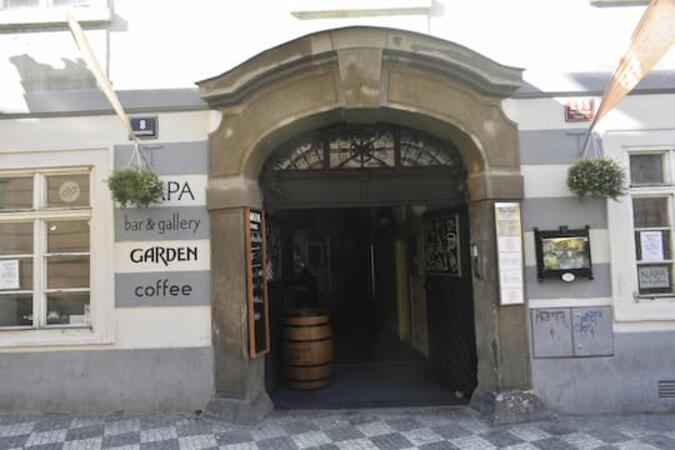
Výcvik Velkých dat je k dispozici jako "živé online školení" nebo "živé školení na místě". Živé online školení (též označované jako "živé vzdálené školení") se koná prostřednictvím interaktivního vzdáleného desktopu. Živé školení na místě lze realizovat lokálně na sídle zákazníka v Prague nebo v korporátních výcvikových centrech NobleProg v Prague.
Jeďte tramvají č. 9 ze zastávky Hlavní nádraží směrem na Sídliště Řepy.
Vystupte na zastávce Újezd.
Pokračujte pěšky asi 10 minut směrem na Malostranské náměstí / Prokopskou.
Pokračujte ulicí Prokopská až na adresu 296/8.
Alternativa: Jeďte metrem linkou C ze stanice Hlavní nádraží do stanice Muzeum, kde přestupte na linku A směrem na Nemocnici Motol. Vystupte ve stanici Malostranská a pokračujte pěšky přes Malou Stranu. Tato varianta zahrnuje více chůze.
z autobusového nádraží Praha – Florenc
Jeďte metrem linky B ze stanice Florenc směrem na Zličín.
Vystupte ve stanici Můstek.
Přestupte na linku A směrem na Nemocnici Motol.
Vystupte ve stanici Malostranská.
Pokračujte pěšky přibližně 10–15 minut na adresu Prokopská 296/8.
Toto živé školení vedené lektorem <na místě> (online nebo na místě) je určeno pro datové vědce a inženýry středně pokročilé úrovně, kteří chtějí využít Google Colab a Apache Spark ke zpracování velkých dat.
Po absolvování tohoto kurzu budou účastníci schopni:
Nastavit prostředí pro práci s velkými daty pomocí Google Colab a Sparku.
Efektivně zpracovávat a analyzovat rozsáhlé datové sady pomocí Apache Sparku.
Vizualizovat velká data v prostředí umožňujícím spolupráci více uživatelů.
Integrovat Apache Spark s nástroji cloudových platforem.
Toto školení vedené lektorem v Prague pokrývá platformu Stratio s důrazem na moduly Rocket a Intelligence s využitím PySpark. Účastníci zvládnou přijímání dat, transformace a pokročilé analytické postupy a získají praktické dovednosti v oblasti smyček, UDF a podnikových toků dat.
Tento živý kurz v oblasti Prague se zabývá koncepty Data Warehousingu, dimenzionálním modelováním a návrhem ETL pipeline. Účastníci postaví hvězdičková schémata, optimalizují OLAP zátěže a implementují správu dat, čímž získají praktické dovednosti pro budování robustních analytických systémů.
Účastníci, kteří absolvují tento praktický kurz pod vedením lektora v Prague, získají reálné znalosti o velkých datech a souvisejících technologiích, metodách a nástrojích.
Během kurzu budou mít účastníci možnost tyto poznatky uplatnit v praxi prostřednictvím názorných cvičení. Důležitou součástí výuky je také spolupráce ve skupinách a zpětná vazba od lektora.
Kurz začíná úvodem do základních konceptů velkých dat, poté se zaměří na programovací jazyky a metody určené k analýze dat. Na závěr rozebíráme nástroje a infrastrukturu umožňující ukládání velkých dat, jejich distribuované zpracování a škálovatelnost.
Tento živý kurz v rámci Prague pomáhá středně pokročilým až pokročilým uživatelům zvládnout architekturu Greenplum a modelování dat. Účastníci se naučí navrhovat distribuované tabulky, používat vysoce výkonný SQL a interpretovat plány EXPLAIN pro optimální provádění dotazů v rozsáhlých analytických prostředích.
Toto školení vedené lektorem v oblasti Prague pokrývá instalaci Greenplum, aktualizace a správu knihoven. Účastníci se naučí konfigurovat klastry, bezpečně aplikovat záplaty a spravovat rozšíření pro pokročilou analýzu dat, čímž si osvojí praktické dovednosti pro reálné prostředí.
Toto školení pod vedením lektora Prague (online nebo na místě) je určeno pro pokročilé pracovníky v oblasti dat, kteří chtějí optimalizovat pracovní postupy při zpracování dat, zajistit jejich integritu a vytvořit robustní řešení typu data lakehouse schopná reagovat na složitosti moderních velkých datových aplikací.
Po absolvování tohoto kurzu budou účastníci schopni:
Hluboce porozumět architektuře Icebergu, včetně správy metadat a uspořádání souborů.
Konfigurovat Iceberg tak, aby dosahoval optimálního výkonu v různých prostředích a integrovat ho s několika nástroji na zpracování dat.
Spravovat rozsáhlé tabulky Iceberg, provádět komplexní změny schématu a řešit evoluci partitions.
Ovládat techniky pro optimalizaci výkonu dotazů a efektivitu skenování velkých datových sad.
Zavádět mechanismy zajišťující konzistenci dat, transakční spolehlivost a odolnost vůči chybám v distribuovaných prostředích.
Tento kurz vedený instruktorem Prague (online nebo prezenčně) je určen pro začínající pracovníky v oblasti dat, kteří si chtějí osvojit znalosti a dovednosti potřebné k efektivnímu využívání Apache Iceberg při správě rozsáhlých datových sad, zajištění integrity dat a optimalizaci procesů jejich zpracování.
Po absolvování tohoto kurzu budou účastníci schopni:
Podrobně porozumět architektuře, vlastnostem a výhodám Apache Iceberg.
Seznámit se s formáty tabulek, dělením dat podle partitioningu, vývojem schémat a možnostmi návratu v čase (time travel).
Nainstalovat a konfigurovat Apache Iceberg v různých prostředích.
Vytvářet, spravovat a upravovat tabulky typu Iceberg.
Pochopit postup migrace dat z jiných formátů tabulek do Apache Iceberg.
Tento kurz vedený instruktorem Prague (online či prezenčně) je určen pro IT profesionály středně pokročilé úrovně, kteří si chtějí rozšířit znalosti v oblasti datové architektury, správy dat, cloud computingu a technologií velkých dat. Cílem je umožnit jim efektivní manipulaci s rozsáhlými daty a jejich migraci v rámci organizací.
Po absolvování tohoto kurzu budou účastníci schopni:
Pochopit základní koncepty a prvky různých datových architektur.
Získat komplexní přehled o principech správy dat a jejich významu v regulačním prostředí.
Implementovat a spravovat rámce pro správu dat, jako jsou Dama a Togaf.
Využívat cloudové platformy k efektivnímu ukládání, zpracování a správě dat.
Toto školení pod vedením instruktora Prague (online nebo na místě) je určeno pro datové inženýry středně pokročilé úrovně, kteří se chtějí naučit využívat Azure Data Lake Storage Gen2 při tvorbě efektivních řešení pro analýzu dat.
Po absolvování tohoto kurzu budou účastníci schopni:
Porozumět architektuře a klíčovým vlastnostem Azure Data Lake Storage Gen2.
Optimalizovat ukládání dat a přístup k nim s ohledem na náklady i výkon.
Integrovat Azure Data Lake Storage Gen2 s dalšími službami Azure pro analýzu a zpracování dat.
Vytvářet řešení využívající rozhraní API Azure Data Lake Storage Gen2.
Řešit běžné problémy a optimalizovat strategie ukládání dat.
Toto školení vedené instruktorem v Prague (online či na místě) je určeno vývojářům, kteří chtějí využívat a integrovat Spark, Hadoop a Python k zpracování, analýze a transformaci rozsáhlých a složitých datových souborů.
Po absolvování tohoto kurzu budou účastníci schopni:
Nastavit potřebné prostředí pro zahájení zpracování velkých dat pomocí Sparku, Hadoopu a Pythonu.
Porozumět vlastnostem, klíčovým komponentám a architektuře Sparku a Hadoopu.
Naučit se integrovat Spark, Hadoop a Python pro zpracování velkých dat.
Poznat nástroje v rámci ekosystému Sparku (Spark MLlib, Spark Streaming, Kafka, Sqoop a Flume).
Vytvořit doporučovací systémy založené na kolaborativní filtraci podobné těm u Netflixu, YouTube, Amazonu, Spotify či Googlu.
Využít Apache Mahout k škálování algoritmů strojového učení.
Tento live školení vedeno lektorem v oblasti Prague pokrývá pokročilé techniky big data, distributivní výpočty a strojové učení velkého rozsahu. Je koncipováno pro pokročilé datové profesionály, kteří chtějí ovládnout analýzu v reálném čase, integraci hlubokého učení a robustní strategie řízení dat.
Toto školení vedené instruktorem v <lok> (online nebo prezenčně) je určeno pro IT profesionály střední úrovně, kteří si chtějí osvojit komplexní znalosti o IBM DataStage jak z administrativního, tak i vývojářského hlediska. Po absolvování kurzu budou schopni tento nástroj efektivně využívat ve svém pracovním prostředí.
Na konci tohoto školení budou účastníci schopni:
Pochopit základní principy IBM DataStage.
Naučit se, jak správně instalovat, konfigurovat a spravovat prostředí IBM DataStage.
Připojit se k různým zdrojům dat a efektivně z nich extrahovat informace – ať už z databází, textových souborů nebo externích systémů.
Tento školení vedené instruktorem v Prague (online nebo na místě) je určeno systémovým administrátorům od úrovně začátečníka po středně pokročilé, kteří chtějí nasadit, udržovat a optimalizovat klastry Spark.
Na konci tohoto školení budou účastníci schopen:
nainstalovat a nakonfigurovat Apache Spark v různých prostředích.
spravovat zdroje klastru a sledovat aplikace Spark.
optimalizovat výkon klastrů Spark.
implementovat opatření pro zabezpečení a zajistit vysokou dostupnost.
V tomto živém školení vedeném instruktorem v Prague se účastníci naučí, jak používat Python a Spark společně pro analýzu velkých dat, přičemž se budou věnovat praktickým úkolům.
Na konci tohoto školení budou účastníci schopni:
Naučit se používat Spark s Pythonem pro analýzu velkých dat.
Pracovat na úkolech, které napodobují reálné případy.
Používat různé nástroje a techniky pro analýzu velkých dat pomocí PySpark.
Prozkoumejte Business Intelligence na základě Big Data pro vládní agentury v Prague. Tento kurz zahrnuje Hadoop, NoSQL, prediktivní analýzu a nástroje pro reálný čas, které slouží k správě rozsáhlých a různorodých toků dat. Naučíte se detekci podvodů, kybernetickou bezpečnost a strategiky návratnosti investic (ROI), aby se nestrukturovaná data stala strategickým aktivem pro úspěšné plnění mise.
Během tohoto školení pod vedením instruktora v místě Prague se účastníci naučí, jaký přístup je třeba zvolit ke technologiím velkých dat, jak posoudit jejich vliv na stávající postupy a politiku a nakonec je nasadí za účelem identifikace trestné činnosti a prevence kriminality. Budou rovněž analyzovány případové studie z celého světa, aby si osvojili postupy, problémy i výsledky jejich implementace.
Po absolvování tohoto školení budou účastníci schopni:
Kombinovat technologie velkých dat s tradičními postupy sběru dat, aby v rámci vyšetřování poskládali celkový obraz situace.
Implementovat průmyslová řešení pro ukládání a zpracování velkých dat určená k jejich analýze.
Připravit návrh na zavedení nejvhodnějších nástrojů a postupů, jež umožní přístup ke kriminalistickému vyšetřování založenému na datech.
Prozkoumejte základy programování s Big Data v jazyce R, který je oblíbený v odvětví financí. Tento kurz v Prague pokrývá nastavení prostředí, MPI pro paralelní zpracování a distributivní matice. Naučte se efektivně pracovat s velkými datovými sadami, provádět distributivní regresi a aplikovat metody Monte Carla.
Toto živé školení s lektorem (online nebo prezenčně) je určeno datovým inženýrům, datovým analytikům a odborníkům v oblasti dat, kteří chtějí využít Databricks a PySpark k budování škálovatelných datových procesů a migraci existujících pracovních postupů založených na SQL.
V Prague tato pětidenní školení seznamuje se systémy pro streamování dat v reálném čase. Pokrývá klíčové koncepty, architektonické vzory a průmyslové nástroje pro zpracování nepřetruditého toku dat ve velkém měřítku. Studenti projektují, implementují a optimalizují škálovatelné streamovací pipeline pomocí moderních frameworků.
Toto školení vedené lektorem v Prague je navrženo pro administrátory střední úrovně, kteří mají za cíl nasadit a spravovat Apache NiFi v produkčním prostředí. Účastníci se naučí konfigurovat klastry, navrhovat dataflows a optimalizovat výkon prostřednictvím praktických laboratoří a cvičení založených na scénářích.
Toto školení poskytuje praktický úvod do tvorby škálovatelných datových procesů a pracovních postupů v oblasti strojového učení s využitím nástroje PySpark. Účastníci se seznámí s tím, jak Apache Spark funguje v rámci moderních ekosystémů pro velká data a jak efektivně zpracovávat rozsáhlé datové soubory na základě principů distribuovaného výpočtu.
Tento třídní praktický kurz se zaměřuje na vytváření a optimalizaci efektivních úloh pro zpracování dat pomocí PySpark, Pandas a Polars v prostředí založeném na Kubernetes.
Účastníci získají praktické pochopení toho, jak se aplikace Spark spouštějí v Kubernetes a jak rozhodnutí o konfiguraci na úrovni aplikace ovlivňují výkon, škálovatelnost, spotřebu zdrojů a náklady. Kurz pokrývá klíčové oblasti optimalizace, včetně dimensionování executorů, alokace paměti, dynamické alokace, strategií rozdělování (partitioning), chování shuffle, problémů s malými soubory a efektivního zpracování formátu Parquet.
Kurz též řeší běžné výzvy při práci s Pandas, včetně omezení paměti a chyb přetečení paměti (out-of-memory), a představuje Polars jako výkonnou alternativu pro vybrané úlohy zpracování dat. Prostřednictvím praktických cvičení budou účastníci diagnostikovat problémy s výkonem a pamětí, porovnávat různé strategie konfigurace a aplikovat techniky optimalizace na realističné scénáře ETL a strojového učení.
Důraz je po celý kurz kladen na praktické rozhodování: pochopení toho, jak identifikovat láhlová hrdla, vybrat vhodný nástroj, efektivně nakonfigurovat Spark a najít rovnováhu mezi výkonem a spotřebou zdrojů infrastruktury a náklady.
Toto školení vedené lektorem Prague (online nebo na místě) je určeno inženýrům, kteří si přejí nastavit a nasadit systém Apache Spark pro zpracování velmi rozsáhlých dat.
Po ukončení tohoto kurzu budou účastníci schopni:
Nainstalovat a nakonfigurovat Apache Spark.
Rychle zpracovávat a analyzovat velmi rozsáhlé datové sady.
Porozumět rozdílům mezi Apache Sparkem a Hadoop MapReduce a vědět, kdy který nástroj použít.
Integrovat Apache Spark s dalšími nástroji pro strojové učení.
Tento praktický školicí program v oblasti Prague zjednodušuje práci s Apache Spark a pokrývá témata jako RDD, DataFrames a API pro Python a Scala. Účastníci si osvojí dovednosti pro nasazení v cloudu pomocí Databricks, AWS EMR a Glue, čímž získají praktické kompetence pro reálné úkoly v oblasti data engineeringu a DevOpsu.
Toto školení pod vedením instruktora <na místě> (online nebo na místě) je určeno technicky zdatným osobám, které chtějí využít Talend Open Studio pro velká data k zjednodušení procesů čtení a analýzy rozsáhlých datových sad.
Po absolvování tohoto kurzu budou účastníci schopni:
Nainstalovat a nastavit Talend Open Studio pro velká data.
Připojit se k systémům určeným k zpracování velkých dat, jako jsou Cloudera, HortonWorks, MapR, Amazon EMR a Apache.
Porozumět a konfigurovat komponenty a konektory pro práci s velkými daty v rámci Open Studio.
Nastavit parametry tak, aby se automaticky generoval kód typu MapReduce.
Využívat rozhraní typu „drag-and-drop“ v Open Studio ke spouštění úloh určených pro Hadoop.
Vytvářet prototypy datových toků pro velká data.
Automatizovat projekty spojené s integrací velkých dat.
Přečtěte si více...
Naposledy aktualizováno:
Reference (7)
Cesta světem Sparku: velmi intenzivní kurz. DSL, Spark SQL, rozdělování oproti kbelíkování pro mě.
Georgiana Elisabeta
Kurz - Apache Spark Fundamentals
Přeloženo strojem
praxe
Liliana Padilla - Hipodromo de Agua Caliente
Kurz - Greenplum Architecture and Data Modeling
Přeloženo strojem
Praktické cvičení. Třída by měla trvat 5 dní, ale i tři dny pomohly rozjasnit spoustu otázek, které jsem měl z práce s NiFi.
James - BHG Financial
Kurz - Apache NiFi for Administrators
Přeloženo strojem
Schopnost vedenáře vyhovět požadavkům organizace při přizpůsobení kurzu, a ne jen ho poskytnout pro formální splnění povinnosti.
Masilonyane - Revenue Services Lesotho
Kurz - Big Data Business Intelligence for Govt. Agencies
Přeloženo strojem
Skutečnost, že jsme mohli s sebou vzít většinu informací, kurzů, prezentací a cvičení, které jsme absolvovali, takže si je můžeme prohlédnout a možná opakovat to, co jsme poprvé nepochopili, nebo vylepšit to, co jsme již udělali.
Raul Mihail Rat - Accenture Industrial SS
Kurz - Python, Spark, and Hadoop for Big Data
Přeloženo strojem
Mít praktické sezení a úkoly
Poornima Chenthamarakshan - Intelligent Medical Objects
Kurz - Apache Spark in the Cloud
Přeloženo strojem
The subject matter and the pace were perfect.
Tim - Ottawa Research and Development Center, Science Technology Branch, Agriculture and Agri-Food Canada
Velké data počítačová školení v Prague
Velké data počítačové kurzy v Prague
Velké data kurzy v Prague
Víkendové Velké data kurzy v Prague
Večerní Velké data školení v Prague, Velké data individuální školení v Prague, Velké data školitel v Prague, Velké data uzavřená školení v Prague, Velké data vedené školitelem v Prague, Víkendové Velké data školení v Prague, Velké data školení v Prague, Večerní Velké data kurzy v Prague, Velké data koučování v Prague, Velké data lektor v Prague, Velké data on-site v Prague, Velké data přijímač v PragueBig Data počítačová školení v Prague
Big Data počítačové kurzy v Prague
Big Data kurzy v Prague
Víkendové Big Data kurzy v Prague
Večerní Big Data školení v Prague, Večerní Big Data kurzy v Prague, Big Data přijímač v Prague, Big Data lektor v Prague, Víkendové Big Data školení v Prague, Big Data školitel v Prague, Big Data uzavřená školení v Prague, Big Data vedené školitelem v Prague, Big Data školení v Prague, Big Data koučování v Prague, Big Data on-site v Prague, Big Data individuální školení v Prague